
«Il vostro agente è stupido.»
Non è il feedback che vuoi ricevere dopo mesi di lavoro.
Soprattutto quando, fino al giorno prima, tutti i tuoi test dicevano il contrario.
Il nostro agente superava quasi il 100% degli evaluation test. Lo abbiamo rilasciato convinti che funzionasse molto bene e, poco dopo, gli utenti hanno iniziato a raccontarci una storia completamente diversa.
Il problema non era il modello scelto, non era nemmeno un bug, avevamo sbagliato qualcosa di molto più sottile:
Avevamo dato per scontato il modo in cui le persone avrebbero usato l'agente.
Ci torneremo tra poco.
È da episodi come questo che nasce questo articolo.
Negli ultimi anni, in VLK Studio, abbiamo costruito agenti e sistemi basati su LLM per i nostri prodotti e per i nostri clienti, fino a metterli nelle mani di migliaia di persone.
Abbiamo provato modelli diversi, cambiato architetture, costruito tool, eval, sistemi di retrieval e workflow che spesso, pochi mesi dopo, abbiamo rimesso completamente in discussione.
Ogni progetto ci ha lasciato qualcosa.
E, curiosamente, le lezioni che ci sono rimaste più impresse raramente sono state del tipo «serviva un modello più potente» o «dovevamo scrivere un prompt migliore».
Molto più spesso erano piccoli accorgimenti.
Capire quando guidare un agente e quando lasciargli spazio. Quando deve fare una domanda e quando può prendere una decisione da solo. Quali strumenti dargli. Quanto fidarsi di un evaluation test. Come permettergli di sbagliare senza fare danni. E, soprattutto, come dargli abbastanza informazioni per capire da solo quando qualcosa non sta funzionando.
Oggi alcune di queste cose ci sembrano quasi ovvie. Non lo erano mentre le stavamo imparando.
Modelli e framework cambiano continuamente e molte delle pratiche che utilizziamo oggi potrebbero sembrarci ingenue tra qualche anno. Alcune lezioni, però, sembrano resistere.
Questo articolo raccoglie quelle che hanno cambiato maggiormente il nostro modo di costruire agenti. Non è un framework né una lista definitiva di best practice: sono piccole lezioni imparate dopo aver sbagliato tanto.
| Lezione | In pratica |
|---|---|
| Non progettare tutti i percorsi | Definisci il perimetro d'azione dell'agente e dagli strumenti e primitive che possa scegliere e combinare in autonomia. |
| Testa il disordine | Gli eval devono includere richieste ambigue, casi negativi, input fuori scope e conversazioni multi-turn, non soltanto happy path. |
| Chiedere è un'azione | Chiedi chiarimenti quando l'informazione mancante può cambiare il risultato, il rischio o ciò che l'agente è autorizzato a fare. |
| Sbagliare non è il problema | Dai all'agente segnali osservabili che gli permettano di accorgersi quando qualcosa non torna, capire perché e correggere la propria direzione. |
| Il feedback è un sensore, non un verdetto | Il risultato di una ricerca o di un tool descrive ciò che l'agente ha osservato, non necessariamente tutto ciò che esiste o la verità completa. |
| Sapere cosa non si sa | L'agente dovrebbe conoscere gli strumenti che possiede, ciò che ha osservato, ciò che non ha ancora osservato e i limiti del proprio ambiente. |
Non siete più furbi dei vostri utenti
Nello sviluppo del software classico è normale dover pensare alle possibili interazioni che un utente può avere con il prodotto e studiare una UX che cerca di prevedere e indirizzare le sue azioni.
Una volta però che dai agli utenti un campo di testo libero per interagire con la tua app, beh, le cose cambiano.
Non puoi prevedere che cosa scriveranno. Sembra un piccolo dettaglio, ma cambia completamente il modo in cui si sviluppa l'agente sottostante.
L'agente è stupido?
Abbiamo sviluppato per un nostro cliente un agente che, per farla breve, doveva trovare documenti in base alle domande degli utenti e generare risposte basate sul loro contenuto.
Inizialmente abbiamo sviluppato un workflow molto rigido:
Ogni query degli utenti veniva utilizzata per effettuare una ricerca semantica dei documenti.
I documenti trovati venivano interpretati in un secondo passaggio e infine veniva generata una risposta.
Era un approccio ragionevole. La richiesta entrava nel sistema, attivava una ricerca, i documenti venivano interpretati e l'agente formulava una risposta.
Per verificare che il workflow funzionasse, avevamo raccolto circa 50 scenari segnalati dal cliente e costruito una suite di Evaluation Tests.
Erano test che utilizzavano un altro LLM come giudice per valutare la risposta in base a una risposta attesa per quella domanda.
Il risultato sembrava ottimo: una percentuale di successo vicina al 100%.
Avevamo quindi buone ragioni per pensare che il sistema fosse pronto per il rilascio.
Una volta rilasciato il bot, abbiamo letto i primi feedback degli utenti: «L'agente è stupido!». Non esattamente quello che ci aspettavamo.
Siamo quindi andati a vedere che cosa gli utenti stavano chiedendo al bot e il risultato ci ha stupito.
Domande tipo:
«AD-12aa45», una stringa di testo apparentemente senza senso che in realtà
era l'identificativo del documento che stavano cercando, buttato così in chat
senza nessun contesto;- «Puoi darmi informazioni su CD?», un acronimo interno del cliente che per il
modello non aveva alcun significato e rischiava di essere confuso con acronimi noti, come Compact Disc; - «Cerca documenti simili al secondo che mi hai proposto», una ricerca basata sulla ricerca precedente che il nostro workflow non prevedeva.
Il problema era chiaro: avevamo immaginato un modo d'uso che non corrispondeva a quello reale.
Il problema era il percorso
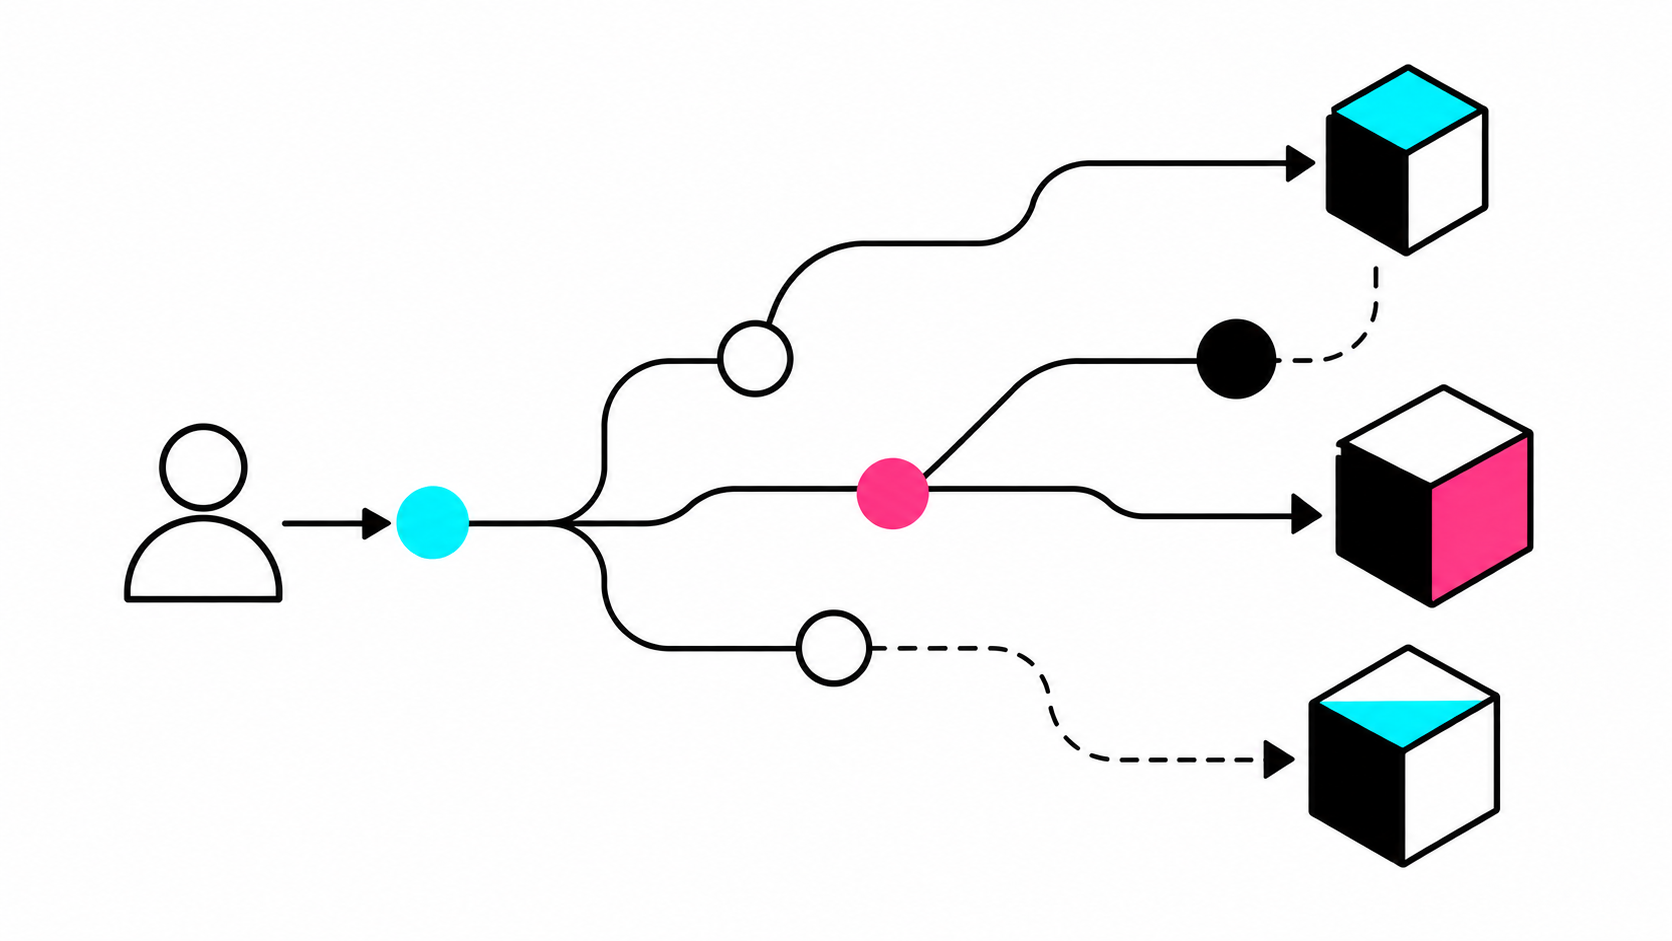
In una classica interfaccia, dove l'utente può compilare un form, seguire un
wizard o cliccare su pulsanti appositi, è possibile progettare una user journey
e cercare di portarlo verso il percorso migliore. Quando invece dai piena
libertà agli utenti di esprimersi attraverso il linguaggio naturale, non puoi
pensare ai flussi esatti. Devi pensare al perimetro di azione.
Il problema non era quindi che il workflow fosse troppo semplice. Era che
avevamo cercato di progettare in anticipo il percorso dell'utente, invece di
definire con chiarezza che cosa l'agente potesse fare.
Il pollice opponibile
Abbiamo quindi fatto una cosa molto semplice:
invece di aggiungere altri rami al workflow, abbiamo dato all'agente il suo “pollice opponibile”: strumenti che potesse scegliere e combinare autonomamente.
Uno per cercare nel testo, uno per applicare filtri, come l'identificativo di un documento, uno per riconoscere gli acronimi interni e così via.
In questo modo l'agente poteva scegliere come affrontare la richiesta, senza
perdere di vista il compito per cui era stato costruito. Non dovevamo prevedere
ogni user journey. Dovevamo definire bene gli obiettivi e le primitive che gli
avrebbero permesso di raggiungerli.
Se dai agli utenti un campo di testo senza limiti, aspettati che ti venga chiesto di tutto.
Definisci bene gli obiettivi e capisci quali sono le primitive che possono permettere all'agente di raggiungerli, dopodiché dagli
libertà di manovra.
Vale solo per gli agenti, o anche per noi comuni mortali?
Un eval può essere perfettamente sbagliato
Avevamo reso l'agente più flessibile. Quando abbiamo provato a misurare questo
miglioramento, però, è successo qualcosa di inaspettato.
Gli ultimi saranno i primi
Per scrupolo abbiamo eseguito nuovamente gli Evaluation Tests sulla nuova
versione. La nostra percezione era che l'agente fosse nettamente migliorato:
più reattivo, più capace di recuperare dagli errori, più interattivo... più
intelligente, insomma.
Sorprendentemente però, i test non ci davano ragione. Il success rate era
diminuito: sfioravamo appena il 70%.
Abbiamo deciso di affidarci alla nostra percezione e di rilasciare il nuovo
agente con dei feature flag, poi abbiamo aspettato i primi feedback. Sospiro di
sollievo: finalmente il chatbot riusciva a gestire casi reali.
Gli utenti erano soddisfatti della sua dinamicità e apprezzavano anche che respingesse alcune
domande, chiedendo più informazioni prima di produrre una risposta corretta.
Gli eval avevano il nostro stesso bias
Torniamo agli eval: che cosa stava succedendo?
Anche i test soffrivano dello stesso bias del workflow. Misuravano molto bene una parte troppo stretta del problema e, proprio per questo, ci davano un falso senso di correttezza.
I casi iniziali erano quasi tutti happy path e presupponevano utenti consapevoli, capaci di formulare richieste chiare e complete.
Domande come:
«Sto ricercando informazioni su ACME Inc. e, in base a quello che trovi, vorrei un'analisi di quali dei nostri servizi posso proporre al loro settore vendite.»
sono perfettamente legittime.
Ma presuppongono una disciplina e una chiarezza che gli utenti reali, semplicemente, non hanno sempre.
Testare il disordine
Da uno strumento che millanta intelligenza ci aspettiamo che sappia reagire anche a domande molto meno strutturate.
Ci aspettiamo anche che sappia riconoscere una richiesta fuori dal proprio scopo.
Un agente incaricato di cercare e analizzare documenti è sicuramente capace di scrivere una poesia sul bellissimo mare
della Sardegna, ma non per questo dovrebbe farlo.
Abbiamo quindi riscritto completamente la suite di test, inserendo query meno strutturate e casi negativi.
In alcuni casi l'agente non doveva rispondere, perché non aveva abbastanza informazioni per proseguire.
Doveva preferire fermarsi, chiedere chiarimenti invece di indovinare e agire di conseguenza.
Conversazioni, non prompt
Inoltre mancava un altro pezzo: testare la conversazione.
Non possiamo testare soltanto interazioni composte da un unico messaggio. Gli utenti iterano sulle
risposte, chiedono approfondimenti, ritornano dopo lunghe discussioni a messaggi precedenti e, a volte, si contraddicono.
Testare questo tipo di interazioni è molto più complesso, ma fa la differenza tra l'essere definiti "stupidi" e l'essere considerati
«uno strumento che ha cambiato completamente il modo in cui lavoro, indispensabile».
Quest'ultimo è stato il feedback più gratificante di questo progetto.
Un eval può misurare una parte del problema in modo molto preciso e, allo stesso tempo, dirti poco su quanto l'agente sia utile nella realtà.
Per capire quando l'agente può continuare e quando deve fermarsi, però, non basta migliorare i test.
Deve anche sapere quando gli manca qualcosa.
Sapere quando fermarsi
Chiedere è un’azione
Permettere all'agente di fermarsi e chiedere conferma o chiarimento è stato sicuramente l'accorgimento più importante di tutti, ma anche uno dei più difficili da maneggiare correttamente.
Questa è stata una delle sorprese più interessanti di quel rilascio: uno dei comportamenti che gli utenti percepivano come più intelligenti era, tecnicamente, un non-fare.
L'agente aveva imparato a fermarsi e chiedere.
Spesso mi piace fare questo esercizio:
Facciamo per un attimo finta che l'agente sia una persona. Gli chiedete:
"Dammi i documenti migliori che trovi sull'intelligenza artificiale"
Migliori... ma in base a cosa?
I più letti? Quelli con le informazioni più accurate? Quelli pubblicati dalle fonti più autorevoli?
Scegliere arbitrariamente una di queste interpretazioni significa tirare un dado e sperare che esca la faccia che avevate in mente.
Una persona probabilmente chiederebbe:
«Cosa intendi per migliori?»
E, una volta ricevuta la risposta, continuerebbe il lavoro.
Perché, allora, abbiamo la presunzione che un agente possa invece indovinare la faccia del dado?
Il costo delle domande
Continuiamo con l'esercizio di prima:
«Come posso abilitare la modalità aereo nel mio telefono?»
Come rispondereste a questa domanda? Pensateci, intanto io procedo con una possibile prosecuzione della conversazione:
«Certo, sono qui per aiutarti. Prima di risponderti ho bisogno di sapere che telefono hai.»
«Ho un iPhone.»
«Okay, che modello?»
«Mmmh… non so, credo il 17. L'aereo parte tra poco, ti prego, dimmi come fare.»
«Capisco la tua frustrazione. È molto importante attivare la modalità aereo prima che l'aereo decolli: da quale città parti?»
«…»
Questa conversazione è volutamente esagerata, ovviamente, ma mi è utile per far passare un concetto:
Disambiguare ha senso quando l'informazione mancante può cambiare significativamente la risposta o la decisione dell'agente.
Troppe domande causano frustrazione e aumentano la possibilità che l'agente si confonda e perda anche il riferimento con il suo obiettivo primario.
Un buon modo per evitare questo comportamento è ragionare al contrario: partire dall'obiettivo e chiedersi quali informazioni servano davvero per raggiungerlo.
"Mi stai chiedendo come attivare la modalità aereo, cosa mi serve per poter rispondere?"
"Dovrei sapere quale telefono certo, ma il procedimento è praticamente lo stesso in tutti i telefoni ormai"
"L'unica possibilità è che abbia un telefono molto datato, ma procedo supponendo che abbia un telefono moderno"
Seguendo questa pratica, l'agente avrebbe risposto immediatamente, senza nessuna domanda:
«Vai nelle impostazioni e troverai subito il tasto per attivare e disattivare la modalità aereo, ti basta cliccare per attivarla, buon viaggio!»
Nessuna interruzione, nessuna frustrazione. Nella speranza che l'utente non abbia un Nokia 3310!
I default sono decisioni
E se invece avesse davvero un Nokia 3310?
Procedere con un default non è neutrale. Procedere senza chiedere significa comunque scegliere per l'utente.
In questo caso è semplice: sarebbe bastato rendere l'ipotesi esplicita: «Nella maggior parte dei telefoni moderni...» e lasciare all'utente una via d'uscita nel caso in cui non valesse per il suo dispositivo.
L’agente deve chiedere quando l’informazione mancante può cambiare il risultato, il rischio o ciò che è autorizzato a fare. Può invece procedere con un default quando l'ipotesi è esplicita e un eventuale errore è poco costoso, reversibile e facile da correggere.
Sia che l’agente proceda sulla base di un'ipotesi, sia che lo faccia dopo aver chiesto conferma all’utente, c’è sempre il rischio di imboccare la strada sbagliata. Soprattutto quando il compito è complesso e richiede molti passaggi.
L’errore è inevitabile.
Errare, d’altronde, è umano. Perseverare è diabolico.
Sbagliare non è il problema
Il problema non è che un agente possa sbagliare.
Il problema è che possa continuare a sbagliare senza accorgersene.
Più gli diamo autonomia, più diventa importante dargli anche qualcosa che possa contraddirlo: un test che fallisce, un errore restituito da un sistema, un dato che non torna, il risultato di un'azione diverso da quello previsto.
È uno dei motivi per cui il software è un ambiente particolarmente favorevole agli agenti.
Quasi ogni azione lascia dietro di sé dei segnali osservabili: il codice compila oppure no, un test passa o fallisce, un'applicazione lascia log e stack trace, una modifica può essere confrontata attraverso un diff.
E spesso l'ambiente non dice soltanto no.
Dice anche perché.
L'agente può quindi provare una soluzione, osservare ciò che è successo e utilizzare quelle informazioni per decidere cosa fare dopo.
Provare. Osservare. Correggere. Provare di nuovo.
Finché qualcosa continua a dirgli se si sta avvicinando o allontanando dal risultato.
È un vantaggio enorme.
Ma non tutti gli ambienti possono farlo allo stesso modo.
Immaginate, per esempio, di chiedere a un agente di scrivere un articolo.
Qualsiasi modello recente è capace di produrre un testo grammaticalmente corretto, ben strutturato e apparentemente completo.
Ma come fa a sapere se è davvero interessante?
Un compilatore può dirgli che alla riga 13 c'è un errore di sintassi. Non esiste un equivalente altrettanto preciso che gli dica:
«Qui hai perso il lettore.»
oppure:
«La frase è formalmente corretta, ma non dice niente che valga la pena ricordare.»
Non significa che la buona scrittura non possa essere valutata. Esistono regole, editor, metriche e, soprattutto, lettori capaci di produrre feedback.
Quel feedback, però, tende a essere meno immediato, meno preciso e più difficile da trasformare nell'azione successiva.
Ed è questa la differenza che ci interessa:
Più l'ambiente riesce a restituire segnali rapidi, specifici e collegati a ciò che l'agente ha appena fatto, più possiamo permettergli di osservare il risultato e correggere autonomamente la propria direzione.
Quando questi segnali esistono naturalmente, abbiamo già una parte importante del loop.
Quando non esistono, dobbiamo trovare un modo per costruirli. Con una cautela: un ambiente che risponde non è necessariamente un ambiente che dice la verità.
Il feedback è un sensore, non un verdetto
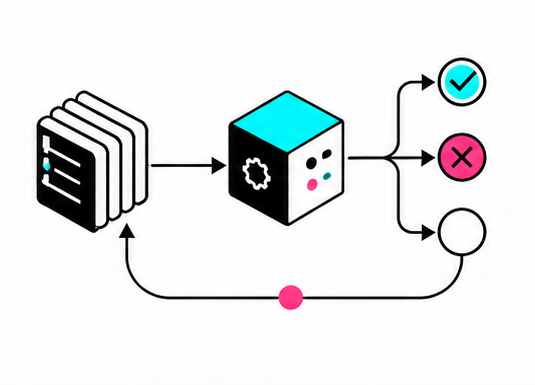
Tornando al nostro stupido agente, un'altra segnalazione che ci era arrivata dai primi test riguardava l'inconsistenza dei risultati.
La stessa richiesta, fatta da utenti diversi, o addirittura ripetuta dallo stesso utente, poteva restituire documenti differenti.
Perché?
Prendiamo una richiesta come:
«Cerca articoli relativi a VLK Studio nel settore dello sviluppo di applicazioni.»
Prima di effettuare la ricerca, l'agente riformulava la richiesta in una forma più adatta alla ricerca semantica.
Una possibile query poteva essere:
VLK Studio software engineering, web and mobile application development
e produrre, per esempio, 4 risultati.
La volta successiva, però, il rephraser poteva interpretare la stessa intenzione in maniera leggermente diversa:
VLK Studio digital product development and engineering case studies
Una query altrettanto sensata.
Eppure poteva recuperare tre documenti diversi, magari soltanto in parte sovrapposti ai precedenti.
Dal punto di vista dell'utente era difficile da spiegare: aveva fatto la stessa domanda, perché l'agente gli stava dando una risposta diversa?
Il problema nasce quando trattiamo il risultato di una ricerca come se fosse un verdetto.
Quei quattro documenti non significano:
«Questi sono gli articoli di VLK Studio relativi allo sviluppo di applicazioni.»
Significano qualcosa di molto più limitato:
«Questi sono i documenti che questa ricerca, formulata in questo modo, ha fatto emergere.»
Una formulazione diversa, un filtro differente o un altro strumento potrebbero mostrarne altri.
Il risultato della ricerca è quindi un'osservazione del corpus, non una fotografia completa di ciò che contiene.
È un sensore.
E, come ogni sensore, può darci abbastanza informazioni per decidere cosa fare dopo senza necessariamente dirci tutta la verità.
Per sapere quanto fidarsi di quei quattro risultati, però, l'agente deve conoscere qualcosa anche del proprio processo: dove ha cercato, con quale query, quali filtri ha applicato, quali fonti erano disponibili e quali no.
Non sapere è un'informazione
Torniamo all’esempio precedente.
Se due query diverse sono entrambe plausibili e possono restituire risultati differenti, come facciamo a dire all’agente:
«Fermati, hai trovato quello che cercavi.»
All'inizio provammo ad aggirare il problema eseguendo due o tre riformulazioni in parallelo.
Nella maggior parte dei casi recuperavano quasi gli stessi documenti. Quando non succedeva, il problema rimaneva comunque irrisolto: non avevamo nessuna garanzia che una quarta query non ne avrebbe trovati altri.
Se l’utente avesse chiesto:
«Trovami tutti gli articoli in cui VLK Studio è associata allo sviluppo software»
non avremmo avuto nessun modo affidabile per sapere quando fermarci.
Il problema non era trovare una query ancora migliore.
Mancavano informazioni sull’ambiente.
L’agente sapeva quali documenti aveva trovato.
Non sapeva quali documenti avrebbe potuto trovare.
A volte basta aggiungere sensori estremamente semplici per cambiare completamente la situazione.
Per non perderci nei dettagli dell’implementazione, semplifichiamo molto il problema e immaginiamo di dare all’agente due piccoli sensori:
Il primo risponde a una domanda molto banale:
«Quanti documenti nell’indice citano VLK Studio?»
Supponiamo che la risposta sia:
10
La nostra ricerca semantica ne ha trovati quattro.
Questo non significa che gli altri sei siano necessariamente rilevanti. Alcuni potrebbero parlare di design, branding o qualsiasi altra attività che non ha nulla a che fare con lo sviluppo software.
Ma ora l’agente sa una cosa che prima ignorava:
esistono altri sei documenti che non ha ancora valutato.
Aggiungiamo quindi un secondo sensore:
«Dato l’ID di un documento, dimmi brevemente di cosa parla.»
Ora l’agente può controllare rapidamente i sei documenti che non erano emersi dalla ricerca iniziale e decidere se qualcuno di essi sia pertinente.
Il processo diventa quindi qualcosa del genere:
- Ricerca semantica:
VLK Studio software engineering, web and mobile application development
→ 4 risultati - Sensore:
Quanti documenti citano VLK Studio?
→ 10 - L’agente sa che esistono altri 6 documenti ancora da valutare.
- Chiede un breve riassunto dei sei documenti mancanti.
- Cinque risultano irrilevanti. Uno invece parla effettivamente di sviluppo software.
- Lo aggiunge ai risultati e risponde all’utente.
Se la ricerca iniziale fosse stata formulata in modo diverso e avesse restituito soltanto tre documenti, il processo sarebbe stato lo stesso.
Avremmo potuto partire da punti diversi e arrivare comunque a un insieme molto simile di risultati.
Non perché la ricerca fosse diventata deterministica, ma perché l’agente aveva finalmente abbastanza informazioni per capire quanto fosse completa la propria osservazione.
Ed è questo che intendo per self-awareness in un agente.
Non coscienza, introspezione o qualcosa di antropomorfico.
Molto più banalmente:
Sapere quali strumenti possiede, cosa ha osservato, cosa non ha ancora osservato e quali limiti ha il proprio ambiente.
Non era stupido. Era limitato.
All’inizio di questo articolo vi abbiamo raccontato del feedback, piuttosto crudele, ricevuto su uno dei nostri primi agenti:
«Il vostro agente è stupido.»
All’epoca il settore era molto meno maturo e noi stavamo imparando quasi tutto mentre costruivamo questi sistemi.
Abbiamo dovuto farci le ossa: sbagliare, capire perché e provare di nuovo.
Nel frattempo siamo cambiati noi ed è cambiato anche il settore. Molte delle lezioni raccontate qui fanno ormai parte di una conversazione molto più ampia.
Col senno di poi, però, possiamo finalmente rispondere a quel primo feedback.
L’agente non era stupido.
Era limitato.
Limitato dai percorsi che avevamo deciso in anticipo per lui.
Limitato da un ambiente che gli permetteva di agire, ma gli diceva troppo poco sulle conseguenze delle sue azioni.
Limitato dalla nostra difficoltà nel capire quando dovesse procedere e quando invece fermarsi, chiedere o cambiare direzione.
E, soprattutto, limitato da ciò che avevamo dato per scontato su come gli utenti lo avrebbero usato.
Nel 2026 i modelli sono diventati straordinariamente capaci. Possono ragionare, usare strumenti, scrivere codice, cercare informazioni e affrontare compiti che soltanto pochi anni fa avremmo considerato fuori portata.
Ma forse la lezione più importante che ci portiamo dietro da questi anni è proprio questa:
un buon modello non basta a costruire un buon agente.
Gli strumenti, le informazioni, il feedback, i confini e la libertà che costruiamo intorno al modello determinano in larga parte ciò che l'agente sarà capace di fare.
Alla fine, un agente è capace quanto l’ambiente che costruiamo intorno a lui gli permette di esserlo.
Come noi.